~/bda/m01 $ cat 04-mapreduce.md
- Big Data Aplicado
- M01
- lección 04/09
MapReduce
El modelo MapReduce
Section titled “El modelo MapReduce”En el bloque anterior ejecutamos un contador de palabras en YARN. Ahora vamos a seguir el recorrido de los datos. Imagina que queremos contar palabras en muchos documentos repartidos por HDFS. Podemos leer varios fragmentos a la vez, pero para obtener el total de una palabra hay que reunir las apariciones que encontraron las distintas tareas. MapReduce organiza ese trabajo en tres pasos.
Fase Map
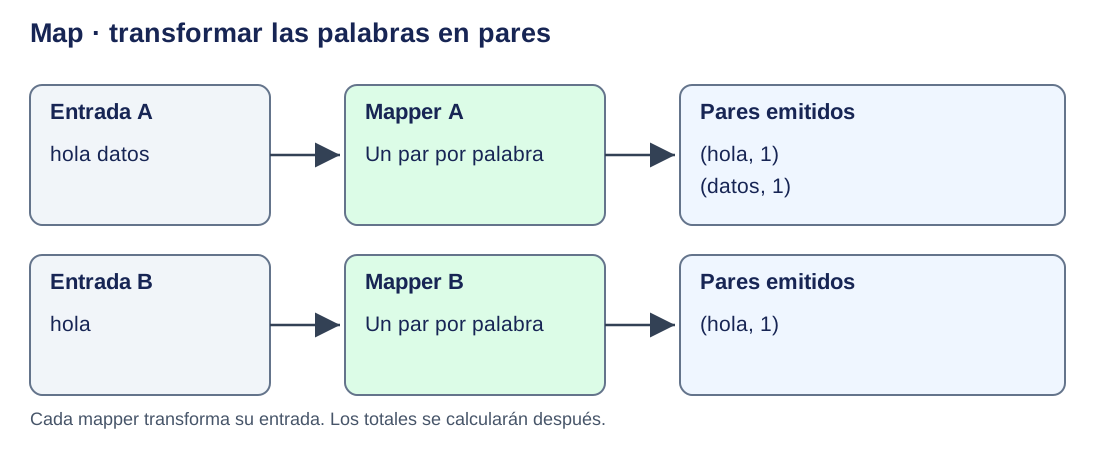
Section titled “Fase Map”La primera fase transforma los datos de entrada en pares clave-valor. Cada par contiene dos elementos que elegimos según el problema que queremos resolver.
- La clave indica por qué dato queremos agrupar los resultados. Para contar palabras, la clave será la palabra.
- El valor aporta la información que necesitaremos para calcular el resultado. Para contar palabras, emitimos un
1por cada aparición.
Hadoop reparte la lectura de los datos entre tareas llamadas mappers. Cada una recibe una parte de la entrada y aplica la misma función a los registros que lee. Por ejemplo, si una tarea recibe el texto hola datos, separa sus palabras y genera estos pares.
(hola, 1)(datos, 1)Otra tarea que lea hola generará el par (hola, 1). Cada tarea trabaja con los datos que le han correspondido. En este punto todavía tenemos las apariciones individuales de cada palabra y falta reunirlas para calcular sus totales.
La transformación depende del problema. Si queremos sumar ventas por tienda, cada registro de venta producirá un par cuya clave será la tienda y cuyo valor será el importe de esa venta.
Fase Shuffle y Sort
Section titled “Fase Shuffle y Sort”Después de transformar los registros, necesitamos reunir todos los valores que tengan la misma clave, aunque los hayan generado tareas diferentes.
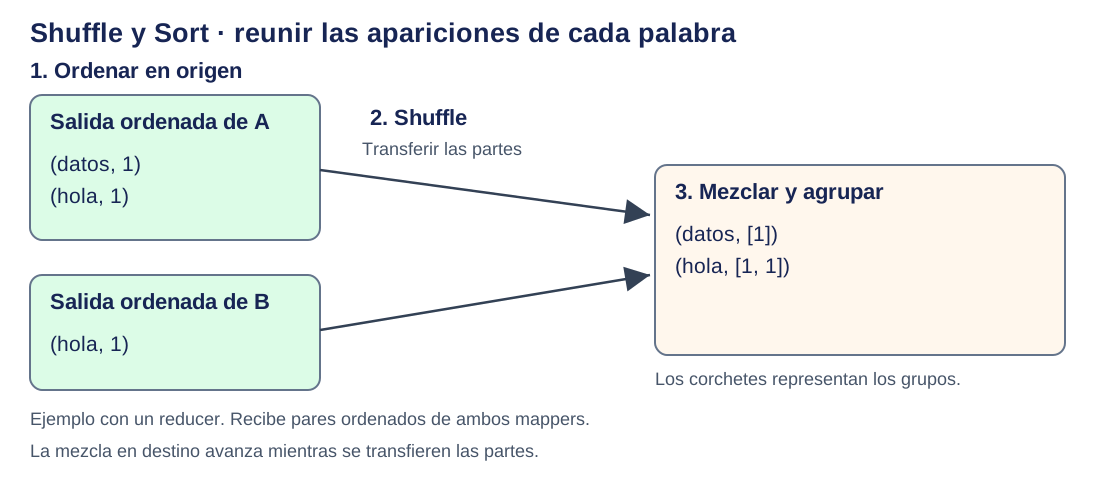
La ordenación interviene tanto antes de transferir los datos como al reunirlos en destino. Podemos seguir el proceso en tres momentos.
- Ordenación en el lado de map. Hadoop prepara la salida de cada mapper, separando los pares según el reducer que los recibirá y ordenándolos por clave dentro de cada parte. Los reducers son las tareas que calcularán los resultados.
- Transferencia o shuffle. Cada reducer recoge de los distintos mappers la parte que le corresponde. Todos los pares con la misma clave se destinan al mismo reducer.
- Mezcla ordenada y agrupación en destino. Hadoop combina las partes recibidas, que ya vienen ordenadas, y reúne los valores de cada clave. Esta mezcla se realiza mientras se reciben los datos, de modo que shuffle y sort se solapan en el lado del reducer.
Por tanto, hay una primera ordenación antes del shuffle. Después, al combinar los datos procedentes de distintos mappers, Hadoop mantiene el orden y completa los grupos por clave. La documentación denomina a este conjunto de operaciones shuffle and sort. Tutorial oficial de MapReduce de Hadoop 3.4.1
En nuestro ejemplo, las dos apariciones de hola se reúnen en un grupo y la aparición de datos queda en otro.
(datos, [1])(hola, [1, 1])Los corchetes nos permiten representar los valores de cada grupo en los apuntes. Así podemos ver que hay un valor para datos y dos para hola. Esta organización prepara el cálculo de la siguiente fase.
Fase Reduce
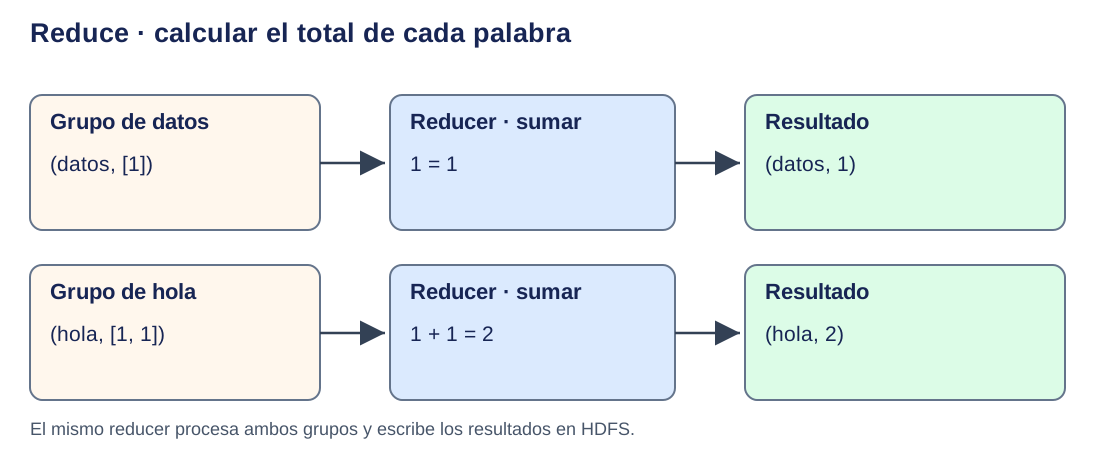
Section titled “Fase Reduce”La fase Reduce calcula el resultado de cada grupo. El programa que realiza este cálculo es el reducer. La operación depende del objetivo del trabajo, por ejemplo sumar, contar o buscar un máximo.
Para nuestro contador, suma los valores asociados a cada palabra.
(datos, [1]) → 1 → (datos, 1)(hola, [1, 1]) → 1 + 1 → (hola, 2)El resultado indica que datos aparece una vez y hola aparece dos veces. Si estuviéramos trabajando con ventas, el reducer sumaría los importes de cada tienda y devolvería su total.
Hadoop guarda la salida del trabajo en el directorio de resultados de HDFS. Si participan varios reducers, cada uno escribe su parte de los resultados en un fichero diferente.
Cómo reparte Hadoop el trabajo
Section titled “Cómo reparte Hadoop el trabajo”Con el recorrido completo en mente, podemos precisar cómo organiza Hadoop la lectura. Un split es la porción lógica de entrada que se asigna a una tarea map. El lector del formato de entrada determina los registros que se procesan en esa porción. Con texto sencillo, cada registro suele ser una línea.
Los bloques HDFS indican cómo se almacenan los datos. Los splits indican cómo se reparte su procesamiento. Su relación depende del formato y de la compresión. Al asignar tareas, Hadoop intenta aprovechar los nodos que ya tienen los bloques necesarios para reducir las transferencias por la red.
El recorrido anterior presenta las fases en el orden en que se transforman los datos. Durante la ejecución, algunas transferencias del shuffle pueden empezar mientras otros mappers siguen trabajando. Más adelante, al escribir nuestros programas con Hadoop Streaming, veremos cómo el reducer lee los pares de cada clave línea a línea y acumula su resultado.
Ejemplos resueltos
Section titled “Ejemplos resueltos”Ejemplos de cómo podemos trabajar con mapreduce en diferentes situaciones.
Contar peticiones por URL
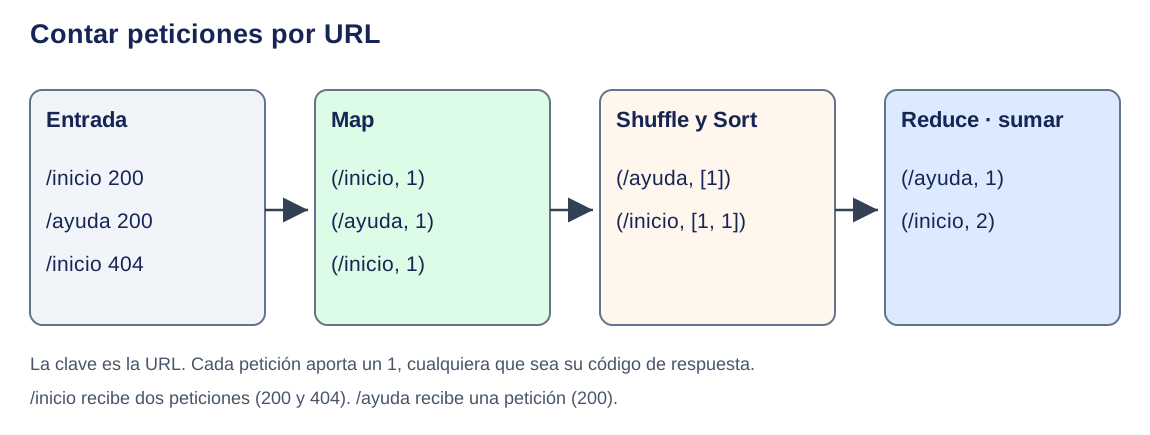
Section titled “Contar peticiones por URL”Queremos contar cuántos accesos recibe cada página de un sitio web. Para ello, vamos a procesar el registro de accesos del servidor, donde cada línea representa una petición e indica la ruta solicitada y el código de respuesta.
Tenemos tres peticiones registradas.
/inicio 200/ayuda 200/inicio 404Queremos obtener el número total de peticiones a cada ruta, incluidas las que terminaron en error. Por tanto, esperamos contar dos accesos a /inicio y uno a /ayuda.
El mapper emite un par por petición, usando la ruta como clave y un 1 como valor. Para estas entradas produce (/inicio, 1), (/ayuda, 1) y (/inicio, 1). Después de agrupar, reduce suma [1] para /ayuda y [1, 1] para /inicio. El resultado es una petición a /ayuda y dos a /inicio.
Buscar el máximo por ubicación
Section titled “Buscar el máximo por ubicación”Para Valencia,21.5, Castellon,23.5 y Valencia,24.0, el mapper emite como clave la ciudad y como valor la temperatura. El reducer recibe [21.5, 24.0] para Valencia y [23.5] para Castellón. Devuelve 24.0 y 23.5, respectivamente. Para calcular el máximo sin guardar la lista, toma el primer valor real de cada grupo y actualízalo con max(maximo, temperatura). Si necesitas un máximo por ciudad y día, usa ambos campos en la clave, por ejemplo Valencia|2026-10-22.
M01-MR-01. Ejercicio Ventas
Section titled “M01-MR-01. Ejercicio Ventas”Una empresa registra ventas de varias tiendas en purchases.txt. Cada línea tiene seis columnas separadas por tabuladores: fecha, hora, tienda, categoría, importe y medio de pago. Vamos a calcular el importe total por tienda. Para ello usaremos la tercera columna como clave y la quinta como valor.
Primero ejecutaremos cada fase localmente para inspeccionar sus resultados. Después pasaremos los mismos programas a Hadoop Streaming, que conecta los procesos Python con Hadoop. En los pasos 1 a 3, cada programa leerá un archivo cuyo nombre recibirá como argumento y escribirá los resultados en pantalla. En el paso 4 adaptaremos la lectura a la entrada estándar (stdin) para conectar los programas mediante tuberías. La salida estándar (stdout) será el flujo de resultados en ambas versiones. Streaming toma como clave el texto anterior al primer tabulador. Hadoop Streaming 3.4.1
Preparar el entorno y los datos
Section titled “Preparar el entorno y los datos”En el anfitrión, desde modulo01/ del laboratorio del bloque 03, arranca el clúster y abre una shell como hadoop en master. En Windows, usa la terminal de Ubuntu en WSL. Preparar el anfitrión
make upmake shellSi usas el modo mini del bloque 03, ejecuta make up-mini y entra en master con make shell. Puedes ejecutar los trabajos y comprobar sus resultados con un solo trabajador. El reparto de bloques y tareas entre trabajadores y la réplica 3 se observan en el modo completo.
La imagen del laboratorio incorpora Python 3 tanto en master como en los trabajadores. Las tareas de YARN necesitan poder ejecutar Python allí donde se lancen.
En master, como hadoop, prepara el directorio de trabajo y comprueba que Python está disponible.
mkdir -p /home/hadoop/ventas-por-tiendacd /home/hadoop/ventas-por-tiendapython3 --versionLa práctica se realiza con el archivo original de ventas, más largo que la muestra que aparece a continuación. Descarga y descomprime el fichero en este directorio dentro de master. curl -fL sigue las redirecciones y detecta errores HTTP; -o indica el nombre de destino. gzip -dk descomprime el archivo y conserva el original comprimido.
Descargar el archivo original purchases.txt.gz
curl -fL -o purchases.txt.gz https://github.com/josepgarcia/datos/raw/refs/heads/main/purchases.txt.gzgzip -dk purchases.txt.gzhead purchases.txtwc -l purchases.txtLa descarga se realiza una vez. Si ya existe purchases.txt, comprueba su contenido antes de repetir la descompresión.
Cada línea representa una venta y contiene seis campos separados por tabuladores, sin cabecera. Los espacios y apóstrofos de los nombres de tiendas y categorías forman parte de sus campos. Por ejemplo, Fort Worth es una sola tienda y Men's Clothing es una sola categoría. El importe usa punto decimal y puede tener uno o dos decimales, como 379.6 o 214.05.
Esta es una muestra de 28 líneas del contenido. Permite entender el formato y comprobar cálculos a mano. Si necesitas una prueba pequeña para depurar, crea purchases-muestra.txt copiando estas líneas y pásalo como argumento a tus scripts. Utiliza purchases.txt, obtenido de la descarga, para ejecutar la práctica completa.
purchases-muestra.txt
2012-01-01 09:00 San Jose Men's Clothing 214.05 Amex2012-01-01 09:00 Fort Worth Women's Clothing 153.57 Visa2012-01-01 09:00 San Diego Music 66.08 Cash2012-01-01 09:00 Pittsburgh Pet Supplies 493.51 Discover2012-01-01 09:00 Omaha Children's Clothing 235.63 MasterCard2012-01-01 09:00 Stockton Men's Clothing 247.18 MasterCard2012-01-01 09:00 Austin Cameras 379.6 Visa2012-01-01 09:00 New York Consumer Electronics 296.8 Cash2012-01-01 09:00 Corpus Christi Toys 25.38 Discover2012-01-01 09:00 Fort Worth Toys 213.88 Visa2012-01-01 09:00 Las Vegas Video Games 53.26 Visa2012-01-01 09:00 Newark Video Games 39.75 Cash2012-01-01 09:00 Austin Cameras 469.63 MasterCard2012-01-01 09:00 Greensboro DVDs 290.82 MasterCard2012-01-01 09:00 San Francisco Music 260.65 Discover2012-01-01 09:00 Lincoln Garden 136.9 Visa2012-01-01 09:00 Buffalo Women's Clothing 483.82 Visa2012-01-01 09:00 San Jose Women's Clothing 215.82 Cash2012-01-01 09:00 Boston Cameras 418.94 Amex2012-01-01 09:00 Houston Baby 309.16 Visa2012-01-01 09:00 Las Vegas Books 93.39 Visa2012-01-01 09:00 Virginia Beach Children's Clothing 376.11 Amex2012-01-01 09:01 Riverside Consumer Electronics 252.88 Cash2012-01-01 09:01 Tulsa Baby 205.06 Visa2012-01-01 09:01 Reno Crafts 88.25 Visa2012-01-01 09:01 Chicago Books 31.08 Cash2012-01-01 09:01 Fort Wayne Men's Clothing 370.55 Amex2012-01-01 09:01 San Bernardino Consumer Electronics 170.2 CashLas ventas de una misma tienda pueden aparecer en líneas separadas. Al ordenar los pares intermedios, esas ventas quedarán juntas para que el reducer calcule su total.
Paso 1. Map: extraer la tienda y el importe
Section titled “Paso 1. Map: extraer la tienda y el importe”Programa mapper_tiendas.py para leer las ventas de un archivo pasado como argumento y escribir un par tienda e importe por línea, separados por un tabulador.
- Importa
sysy recoge el nombre del archivo consys.argv[1].sys.argv[0]contiene el nombre del script; el primer argumento está en la posición 1. Comprueba que se ha recibido exactamente un argumento de entrada. - Abre ese archivo con
with open(sys.argv[1], encoding="utf-8") as entrada:y recórrelo línea a línea confor linea in entrada. El bloquewithcierra el archivo al terminar. - Elimina el salto de línea y separa los campos con
split('\t'). La tienda está en la tercera columna y el importe en la quinta. - Para trabajar con importes, importa
Decimaldedecimaly convierte el texto conDecimal(importe). Puedes mostrar dos decimales con el formato:.2f. - Descarta filas con un número de campos incorrecto o un importe inválido.
Decimalpuede lanzarInvalidOperation, que se importa dedecimal. Comprueba también que el importe sea finito conis_finite()y que no sea negativo. Escribe los avisos conprint(..., file=sys.stderr)para conservar la salida estándar como flujo de pares.
Ejecuta tu programa y guarda los pares en ventas-mapeadas.tsv. La extensión .tsv indica que los campos están separados por tabuladores.
python3 mapper_tiendas.py purchases.txt > ventas-mapeadas.tsvhead ventas-mapeadas.tsvLas primeras líneas deben conservar las tiendas e importes de la entrada.
San Jose 214.05Fort Worth 153.57San Diego 66.08Pittsburgh 493.51Omaha 235.63Paso 2. Ordenar los pares y observar los grupos
Section titled “Paso 2. Ordenar los pares y observar los grupos”sort ventas-mapeadas.tsv > ventas-mapeadas-ordenadas.tsvhead ventas-mapeadas-ordenadas.tsvInspecciona también las ventas de una tienda concreta. Por ejemplo, estas son las líneas de Fort Worth al ordenar únicamente la muestra de 28 registros.
Fort Worth 153.57Fort Worth 213.88El archivo completo contiene más ventas y el grupo de cada tienda puede ser mayor.
Como la tienda está al principio de cada par, las líneas de una misma tienda quedan consecutivas. Aquí ejecutamos sort sobre un archivo local dentro de master.
En Hadoop, cada tarea map ordena sus pares en el nodo donde se ejecuta. Después, cada tarea reduce recoge de los distintos mappers las partes que le corresponden y las mezcla manteniendo el orden por clave. Este trabajo se reparte entre los nodos que ejecutan las tareas; un nodo puede ejecutar varias tareas.
En el paso 5 configuraremos un único reducer. Por eso, aunque haya varias tareas map, la mezcla final de todos sus pares y el cálculo de los totales se realizarán en el nodo donde YARN ejecute ese reducer. Con varios reducers, cada uno recibiría y procesaría su parte de las claves.
Paso 3. Reduce: sumar y cerrar cada grupo
Section titled “Paso 3. Reduce: sumar y cerrar cada grupo”Programa reducer_tiendas.py para leer los pares ordenados de un archivo pasado como argumento y escribir el importe total por tienda.
- Recoge el archivo de entrada de
sys.argv[1], comprueba el argumento y ábrelo conwith open(...), como en el mapper. - Recorre sus líneas y separa la tienda y el importe por el tabulador.
- Guarda la tienda que estás procesando y un acumulador con su total. Usa
Decimalpara sumar los importes. - Cuando aparezca otra tienda, escribe el total de la anterior y empieza el nuevo grupo.
- Al terminar la entrada, escribe también el último grupo. Si no hay datos, la salida debe quedar vacía.
Si pruebas primero con la muestra de 28 líneas, comprueba a mano Fort Worth (153.57 + 213.88 = 367.45) y San Jose (214.05 + 215.82 = 429.87). Con el archivo completo, los totales incluirán todas las ventas de cada tienda. Ejecuta el programa sobre el archivo ordenado y guarda su salida en totales-por-tienda.tsv.
python3 reducer_tiendas.py ventas-mapeadas-ordenadas.tsv > totales-por-tienda.tsvcat totales-por-tienda.tsvLa salida debe contener una línea por tienda. Los totales calculados a mano sobre la muestra solo sirven para verificar una ejecución con purchases-muestra.txt. Para el archivo completo, comprobaremos que coinciden las salidas del proceso por archivos, la tubería y Hadoop.
Paso 4. Unir las fases en una tubería
Section titled “Paso 4. Unir las fases en una tubería”Hasta aquí, cada script ha abierto el archivo que le hemos indicado como argumento. Ahora vamos a adaptar ambos programas para que lean los datos que les envía el proceso anterior mediante una tubería.
Guarda una copia de las primeras versiones como mapper_tiendas_archivo.py y reducer_tiendas_archivo.py antes de modificarlas.
cp mapper_tiendas.py mapper_tiendas_archivo.pycp reducer_tiendas.py reducer_tiendas_archivo.pyLa adaptación consiste en cambiar de dónde se leen las líneas. Este ejemplo muestra el cambio con un programa sencillo que lee líneas y las imprime. Aplica la misma transformación a tus dos scripts, conservando el procesamiento que has programado.
Antes, leyendo un archivo recibido como argumento.
# Ejemplo de lectura desde un archivo
with open(sys.argv[1], encoding="utf-8") as entrada:    for linea in entrada:        print(linea.rstrip('\r\n'))
Después, leyendo de la entrada estándar.
# Ejemplo de lectura desde una tubería
for linea in sys.stdin:    print(linea.rstrip('\r\n'))
En tus scripts, el lugar de print(linea.rstrip('\r\n')) lo ocupa el código que procesa cada línea. Al quitar el bloque with, el bucle queda directamente en el nivel principal del programa. En el reducer, la inicialización de la tienda y del total sigue antes del bucle, y la escritura del último grupo sigue después del bucle.
sys.stdin recibe las líneas que envía el proceso anterior. En la tubería siguiente, cat envía las ventas al mapper, sort recibe sus pares y el reducer recibe los pares ordenados. Por eso ahora ejecutamos ambos scripts sin un argumento de archivo.
Ejecuta la tubería completa. cmp compara su salida con los totales obtenidos en el paso 3. Si coinciden, termina sin mostrar diferencias.
cat purchases.txt | python3 mapper_tiendas.py | sort | python3 reducer_tiendas.py > salida-tuberia.tsvcmp totales-por-tienda.tsv salida-tuberia.tsvPaso 5. Ejecutar los mismos scripts en Hadoop
Section titled “Paso 5. Ejecutar los mismos scripts en Hadoop”Sigue en master como hadoop, dentro de /home/hadoop/ventas-por-tienda. Sube la entrada a HDFS y elige un directorio de salida que todavía no exista. Si la comprobación avisa de que existe, cambia la variable salida a una ruta nueva antes de lanzar el trabajo.
hdfs dfs -mkdir -p /datos/m01-04/ventashdfs dfs -put -f purchases.txt /datos/m01-04/ventas/purchases.txthdfs dfs -head /datos/m01-04/ventas/purchases.txtyarn node -listsalida=/datos/m01-04/salidas/ventas-por-tiendahdfs dfs -test -e "$salida" && echo 'La salida ya existe: elige otra ruta'Utiliza las versiones adaptadas a sys.stdin en el paso 4. Hadoop Streaming enviará los registros por la entrada estándar de cada proceso.
-files distribuye los dos scripts a los directorios locales de las tareas. Esta opción y -D van antes que las opciones de Streaming. Usamos un único reducer para facilitar la comparación de la salida. Hadoop se ocupa de la agrupación entre map y reduce.
hadoop jar /opt/hadoop/share/hadoop/tools/lib/hadoop-streaming-3.4.1.jar \  -D mapreduce.job.reduces=1 \  -files mapper_tiendas.py,reducer_tiendas.py \  -input /datos/m01-04/ventas/purchases.txt \  -output "$salida" \  -mapper 'python3 mapper_tiendas.py' \  -reducer 'python3 reducer_tiendas.py'
hdfs dfs -ls "$salida"hdfs dfs -cat "$salida/part-*" > salida-hdfs.tsvcat salida-hdfs.tsvsort totales-por-tienda.tsv > totales-comparacion.tsvsort salida-hdfs.tsv > hdfs-comparacion.tsvcmp totales-comparacion.tsv hdfs-comparacion.tsv
Antes de comparar, ordenamos ambas salidas con el mismo sort. Hadoop y la configuración regional de la terminal pueden colocar nombres como Newark y New York en distinto orden. Esta diferencia de posición no cambia los totales por tienda.
Comprueba que el directorio contiene _SUCCESS y un fichero part-* con los totales por tienda. Localiza en YARN la aplicación y revisa cuántas tareas de cada tipo se ejecutaron. La prueba muestra la lectura y escritura en HDFS y la ejecución de las fases en YARN. Aunque el archivo sea más largo, ejecutar los contenedores en un solo equipo no demuestra escalabilidad física ni recuperación ante fallos del anfitrión.
Si el resultado difiere, vuelve al primer paso donde cambian los datos. Si faltan ventas en ventas-mapeadas.tsv, revisa los tabuladores y los mensajes del mapper. Si una tienda aparece más de una vez en el resultado, comprueba que todas sus filas quedaron juntas en ventas-mapeadas-ordenadas.tsv. Si el cálculo local funciona y la aplicación falla, revisa en YARN el diagnóstico de la tarea y comprueba que ambos scripts figuran en -files.
Evidencias de la práctica. Conserva las versiones de los scripts que leen archivos, las adaptadas a tuberías, las salidas de las tres fases locales y la salida HDFS. Explica qué muestran las filas separadas de Fort Worth antes y después de ordenar, y anota el identificador de la aplicación YARN.
Ejercicios
Section titled “Ejercicios”Variantes sobre el ejercicio Ventas
Section titled “Variantes sobre el ejercicio Ventas”Reutiliza purchases.txt y prueba tus variantes con la tubería local. Conserva los scripts originales para comparar. Para cada variante indica qué clave y valor emite map, qué operación aplica reduce y cómo verificaste el resultado con la muestra.
M01-MR-06. Total por categoría
Section titled “M01-MR-06. Total por categoría”Suma el importe de las ventas de cada categoría.
M01-MR-07. Venta más alta por medio de pago
Section titled “M01-MR-07. Venta más alta por medio de pago”Para cada medio de pago, devuelve el importe de su mayor venta individual.
M01-MR-08. Venta más alta del fichero
Section titled “M01-MR-08. Venta más alta del fichero”Obtén el mayor importe de toda la muestra.
M01-MR-09. Importe total del fichero
Section titled “M01-MR-09. Importe total del fichero”Contrasta el resultado con la suma de los tres subtotales por tienda de la práctica guiada. Explica por qué una clave constante concentra ese cálculo en un único reducer.
Otros ejercicios
Section titled “Otros ejercicios”A continuación resolveremos cuatro ejercicios con datos nuevos: temperatura máxima (M01-MR-02), consumo por turno (M01-MR-03), valor de inventario (M01-MR-04) y precio medio por producto (M01-MR-05). Sus datos están en los archivos temperaturas.csv, consumos.csv, inventario.csv y precios.csv.
Estos archivos están en la carpeta modulo01/mapreduce/ del repositorio BigDataAplicadoLab_2627, que clonamos para preparar el clúster en el bloque 03. En esa misma carpeta están ventas.csv y los scripts mapper_ventas.py y reducer_ventas.py. Los usaremos primero como ejemplo resuelto para aprender a leer un CSV con cabecera antes de programar los cuatro ejercicios.
Ver los archivos de MapReduce en GitHub
Sal de master con exit. En el anfitrión, entra en BigDataAplicadoLab_2627/modulo01/, dentro de tu copia del repositorio. make copiar-mapreduce copia el contenido de su carpeta mapreduce/ a /home/hadoop/trabajo/ dentro de master. Después, make shell abre de nuevo la terminal del contenedor como hadoop.
make copiar-mapreducemake shellDentro de master, como hadoop, entra en /home/hadoop/trabajo/. El archivo ventas.csv que acabas de copiar tiene producto, categoría, unidades y precio unitario. Aquí el mapper calcula el importe con unidades × precio. El protocolo entre fases sigue siendo un par separado por tabulador, así que podemos seguir usando el mismo patrón de reducción.
cd /home/hadoop/trabajocat ventas.csvpython3 mapper_ventas.py < ventas.csv | sort | python3 reducer_ventas.pyLa salida esperada es audio 164.80 y perifericos 75.00. Abre mapper_ventas.py y fíjate en cómo usa csv.reader(sys.stdin) para separar campos, incluso si una coma aparece dentro de un campo entrecomillado. La muestra admite un registro por línea. Para reconocer la cabecera, comprueba su contenido. Saltarse siempre la primera línea haría perder un registro válido en las tareas que reciben fragmentos sin cabecera. El manejo de Decimal, InvalidOperation y stderr sigue el mismo patrón que en el ejercicio guiado.
Ejercicios con archivos CSV
Section titled “Ejercicios con archivos CSV”Para cada ejercicio, conserva los scripts, la salida de la prueba local y una comprobación manual. Explica cómo elegiste la clave. Si se pide también la ejecución en YARN, reutiliza el paso 5 con el CSV, los scripts y una salida propios del ejercicio.
M01-MR-02. Temperatura máxima
Section titled “M01-MR-02. Temperatura máxima”temperaturas.csv contiene:
temperaturas.csv
fecha,ciudad,temperatura2026-10-22,Valencia,21.52026-10-22,Valencia,24.02026-10-22,Valencia,22.02026-10-22,Castellon,20.02026-10-22,Castellon,23.52026-10-23,Valencia,19.0Primero conserva el mayor valor por ciudad|fecha. Después cambia solo el criterio de agrupación para obtener la máxima por ciudad de toda la muestra. Predice a mano el máximo de las tres primeras filas antes de ejecutar. Se aceptan temperaturas negativas: no confundas un mínimo de inicialización igual a cero con el menor valor posible. El reducer debe iniciar cada grupo con su primer valor real.
M01-MR-03. Consumo por turno
Section titled “M01-MR-03. Consumo por turno”equipo,turno,kwhE1,manana,12.5E2,manana,7.5E3,tarde,4.0E4,tarde,6.0E5,noche,-2.0E6,noche,10.0E7,manana,1001.0E8,noche,errorEl archivo es consumos.csv. Para esta práctica, una medida válida es un número finito entre 0 y 1000 kWh, ambos incluidos. Los valores negativos, superiores a 1000, no numéricos o no finitos son inválidos. Suma únicamente las medidas válidas por turno y registra las filas descartadas en stderr. Justifica por qué el diagnóstico no debe escribirse en el flujo de pares intermedios.
M01-MR-04. Valor de inventario
Section titled “M01-MR-04. Valor de inventario”producto,categoria,stock,precioraton,perifericos,3,20.00teclado,perifericos,2,50.00altavoz,audio,4,25.00auriculares,audio,1,80.00El archivo es inventario.csv. Calcula por categoría la suma de stock × precio, con dos decimales. El stock de esta muestra es entero no negativo y el precio decimal no negativo; utiliza las mismas precauciones de importes del ejemplo de ventas. Explica por qué sumar solo los precios unitarios produciría otro indicador.
M01-MR-05. Una media necesita suma y contador
Section titled “M01-MR-05. Una media necesita suma y contador”producto,precioraton,10.00raton,20.00raton,30.00teclado,40.00teclado,60.00El archivo es precios.csv. Calcula el precio medio de cada producto, con dos decimales. Emite un par producto y precio por cada registro. Dentro de cada grupo, además de sumar los precios, incrementa un contador en uno por cada par recibido. Al cerrar el grupo, divide la suma entre el contador y reinicia ambos acumuladores para el siguiente producto.
Explica además por qué no puedes promediar sin más las medias de dos fragmentos con distinto número de registros. Usa para tu argumento las dos primeras observaciones de raton en un fragmento y la tercera en otro; proporciona tanto sus tamaños como sus sumas.
Estas actividades forman un banco de práctica formativa; su identificación no las convierte automáticamente en entregas calificables. El docente concreta en Aules qué trabajo se solicita y, si corresponde, sus criterios de evaluación.
MapReduce y Spark
Section titled “MapReduce y Spark”Hadoop MapReduce ordena y transfiere la salida intermedia de los mappers, con apoyo del disco local. Al encadenar varios trabajos, cada uno suele materializar su resultado en HDFS. Spark ofrece APIs de más alto nivel y puede aprovechar memoria, por lo que será la herramienta principal de M03. Claves, agrupación y particionado siguen siendo necesarios en ambos modelos.
| Idea aprendida con MapReduce | Continuidad en Spark |
|---|---|
| Transformar registros de entrada | Transformaciones sobre DataFrames. |
| Agrupar por clave | groupBy, agregaciones y particionado. |
| Separar cálculo intermedio y resultado | Plan de ejecución y fases de shuffle. |
| Comprobar datos y salida | Esquema, resultados y registros del job. |
En este bloque hemos leído texto y escrito pares separados por tabuladores. En el siguiente veremos cómo elegir el formato de los datos de entrada y de salida según su estructura y las consultas que necesitemos hacer.